街景 3DGS 补课 · 第四课 · 2026-09-03
插值、外推,以及为什么会崩
前三课讲的是模型怎么建、代码在哪。这一课讲怎么量它——而这恰恰是整个课题里最容易出错、也最有话可说的地方。你 09-02 那晚做的分区评测协议,是目前手上最扎实的一块东西。
为什么这一课最要紧
一个模型好不好,取决于你怎么问它。换一种留法,同一个模型可以从 27 dB 掉到 16 dB——不是模型变了,是问题变了。所以在讨论「哪个方法更好」之前,得先说清楚「好」是按什么量的。
这一课要建立的核心区分只有一条:
| 常规 NVS 协议 | 留出整条相机 | |
|---|---|---|
| 留什么 | 每隔 10 个时间步整列留出 | 某几条相机的全部帧 |
| 测试视角离训练视角多远 | 时间上前后各半秒,空间上几米 | 空间上偏离整条轨迹 |
| 本质在问 | 能不能在轨迹附近插值 | 能不能看到轨迹之外 |
| 典型读数 | 27 dB 左右 | 整图 15 到 16 dB |
| 能支撑的结论 | 重建质量 | 外推能力,但必须分区才有意义 |
最后那句加粗的是本课的重点,也是 §4 到 §7 要展开的东西。
常规协议测的是时间插值
第二课 §7 讲过切法:test_image_stride=10,每隔 10 个时间步整列进测试集,150 帧里留出 14 个时间步、42 张图。关键在于整列一起留——一个时间步被划走,这一刻三个相机的图全都走。
后果是:每个测试帧的左右两侧各有一个训练帧,时间上差 0.1 秒,空间上车往前走了几米。而且那两个训练帧上,几乎所有内容都跟测试帧重合。所以这个协议问的是「你能不能在两张见过的图之间插一张」。
DriveStudio 的评测入口是 tools/eval.py 的 do_evaluation(),它跑两遍:测试集出 metrics/images_test_*.json,全集出 images_full_*.json。分区指标(occupied_psnr / vehicle_psnr / human_psnr)是靠第二课 §1.1 说的 class_labels 做掩码重渲得到的。
它测的是真问题:重建保真度。你八月那批工程加速实验,判据就该是它——因为你要证明的是「加速之后重建质量没掉」,那正是插值质量。问题只出在把它的读数当成外推能力的证据。27 dB 说明模型能在轨迹附近插值,不说明它知道路边那栋楼的侧面长什么样。
换一种留法:留出整条相机
要测外推,就得让测试视角在空间上离开训练轨迹。最省事的做法是:把某几条相机的所有帧全部划走,一帧都不给模型看。
你做了两组,设定不一样,正好互为对照:
| 场景 | ego 位移 | 留出 | 训练用 | 测试帧数 |
|---|---|---|---|---|
| s23 | 0 米(车停着) | 相机 2(前右) | 相机 0、1 | 151 |
| s552 | 约 28 米 | 相机 3、4(左右侧) | 相机 0、1、2 | 282 |
这两组的差别不只是场景。s23 的车根本没动(第二课 §3 讲过判据,这个场景连刚体节点都开不出来),所以它的三个相机就是三个固定视点,测的是「从一个固定视点跳到另一个固定视点」;s552 有 28 米位移,测的是「从行驶轨迹跳到轨迹侧面」。
代码上要动的地方在 preexp/patch_heldout_cam.py:把留出相机从训练 split 里摘掉,同时保证它们仍然进测试 split。第三课 §6 的改动索引里「改训练测试切分」那条指的就是这件事——现有代码只有「按时间步切」的概念,「按相机切」得自己加。
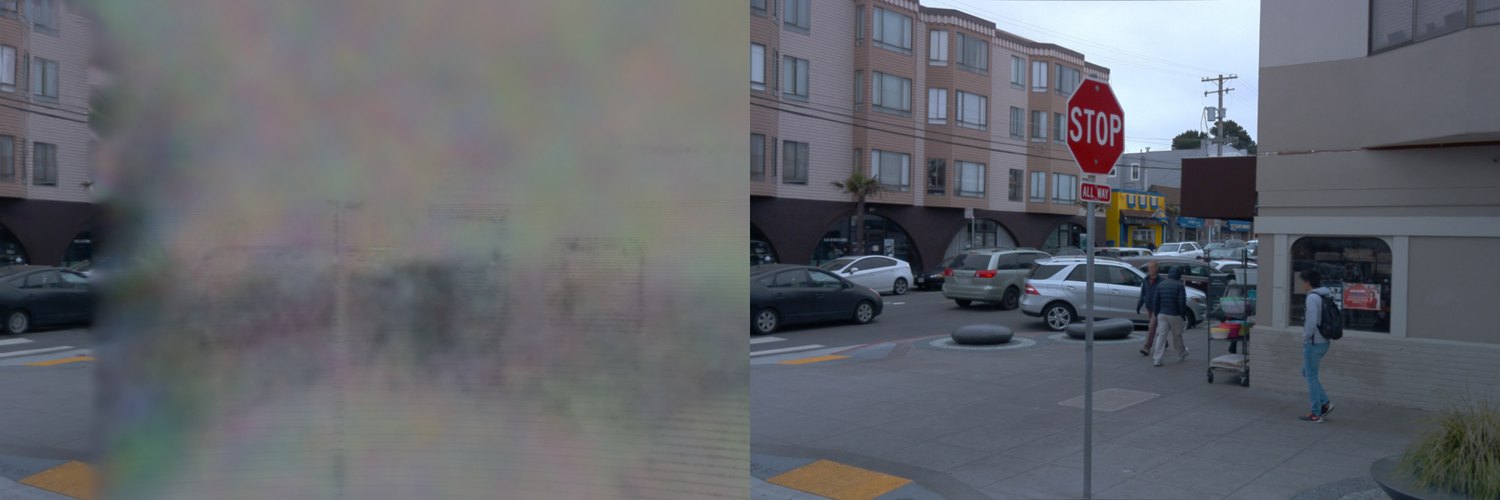
第一眼:大半画面根本没人看过
在讨论任何指标之前,先看一眼渲染出来是什么样。这是 s23,留出的前右相机:
再看 s552,行驶场景的侧相机。第三块是分区掩码,红色是没人看过的,绿色是被至少一个训练视角看过的:
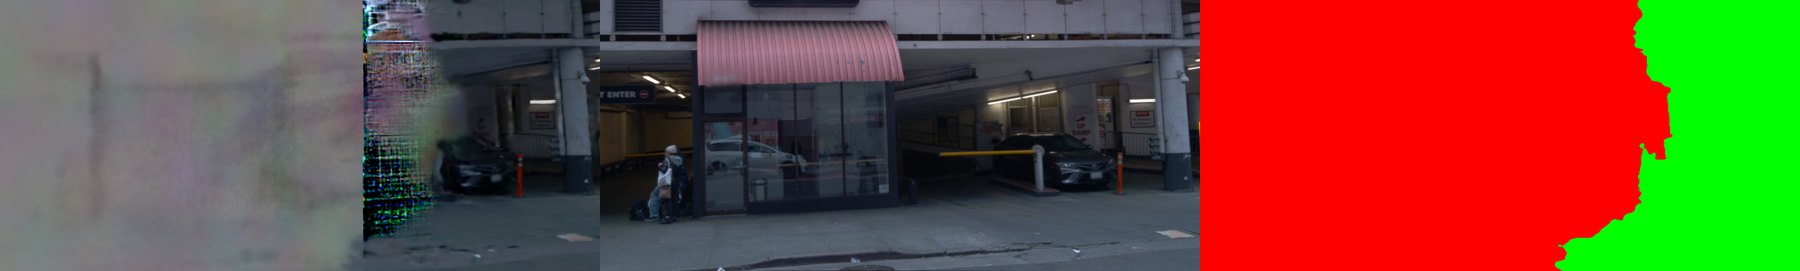
两个场景的整体情况:
| 场景 | 观测区 | 未观测区 | 天空 | 逐帧观测比例的跨度 |
|---|---|---|---|---|
| s23(静止,留前右) | 11.0% | 82.0% | 7.0% | 每帧都是 11.0%(车没动,构型不变) |
| s552(行驶,留侧相机) | 67.2% | 32.8% | 0.0% | 中位 82.6%,但最低到 9.6%、最高 100% |
最后一列值得多看两眼。s552 的平均值 67% 掩盖了巨大的逐帧差异:有的帧全被看过,有的帧只剩不到一成。只报一个平均数会把这个结构完全抹掉。
怎么判定一个像素「被看过」
掩码不是拍脑袋画的,是算出来的。preexp/eval_heldout_masked.py 对留出相机的每一帧做四步:
- 渲染,拿到 RGB、深度、不透明度。
- 反投影:用渲染出来的深度,把每个像素还原成一个三维点。
- 视锥测试:把这个三维点投影到所有训练相机的所有帧上,数它落进了几个视锥。
- 分三类:天空(用数据集的天空掩码)、观测(落进 ≥
min_views个视锥)、未观测(其余)。
\(P_p\) 是像素 \(p\) 反投影出来的三维点,\(\pi_{c,f}\) 是训练相机 \(c\) 在第 \(f\) 帧的投影,\(k\) 就是 min_views,默认 1。
直觉上就是问一句:这块东西,训练的时候有没有哪怕一台相机、哪怕一帧,把它框进过画面里?没有的话,模型对它的一切都是编的。
仪器 1 · 视锥重叠决定了观测比例
俯视示意。灰色是三个前向训练相机的视锥并集,橙色是留出的侧相机。拖它的朝向和位置,看重叠部分怎么变。
朝向拉到 0° 时侧相机跟前向相机看同一片,重叠接近满;拉到 90° 时它看的是正侧方,跟前向视锥几乎不沾边。真实的六相机 rig 就落在中间某处,所以留出侧相机会得到一个「一部分重合、一部分全新」的画面——这正是需要分区的原因。
这个协议自己的弱点
要拿它写论文,就得先把它的毛病摆在明面上。三条,按严重程度排:
5.1 分区用的是渲染深度,不是真深度
第二步的反投影靠模型自己渲染出来的深度。如果几何本身是错的,分区也跟着错。而未观测区恰恰是几何最不可信的地方——一个死循环。
这不是纸上谈兵。你自己的数据里就有一个实例:s23 的 15k 步 checkpoint,算出来观测比例是 0.0%,观测区 PSNR 直接是 nan。同一个场景的 5k 和 30k 都是稳定的 11.0%。
| checkpoint | 观测 | 未观测 | 天空 | 观测区 PSNR |
|---|---|---|---|---|
| 5 000 步 | 11.0% | 82.0% | 7.0% | 21.58 |
| 15 000 步 | 0.0% | 99.9% | 0.1% | nan |
| 30 000 步 | 11.0% | 82.0% | 7.0% | 22.59 |
中间那行显然不是「模型在 15k 步时突然什么都看不见了」,而是那一版渲染深度把像素反投影到了离谱的位置,全部落在所有训练视锥之外。要写进论文的话,这一格必须解释或重跑,不能当作一个数据点混在里面。
5.2 视锥测试不查遮挡
「落进画面」不等于「看得见」。一个点可能在训练相机的视锥里,但被前面的墙挡住了。协议没做遮挡测试,所以「观测」这一类是偏乐观的——里面混着一些实际上被挡住、模型同样没有信息的像素。
这个偏差的方向是明确的:它让观测区的 PSNR 偏低(掺了没信息的像素),让两区的差距被低估。所以你现在测到的差距是个下界,这对你的结论是有利方向,写的时候可以直说。
5.3 min_views = 1 是最宽松的门槛
只要被任何一帧扫到过一次就算「观测」。但看过一次和看过五十次,对重建的意义完全不同——这正是你八月共视性统计的出发点。把 \(k\) 调大,观测区会缩小、但含金量更高。这是个现成的消融维度,扫一遍 \(k=1,5,20\) 就能给出「观测充分度—质量」的曲线。
曝光:必须后拟合,还得挑地方拟合
第二课 §6.2 讲过为什么留出视角必须后拟合一个全局仿射:曝光嵌入是逐图像学的,测试时退化成平均值,残差全算进 PSNR。这一节讲的是更细的一层——仿射在哪些像素上拟合,结论会反过来。
你的评测脚本是这么写的:
# preexp/eval_heldout_masked.py
rgb_aff = affine_fit(rgb, gt, observed)   # 仿射只在观测区拟合,避免被未观测区的噪声带偏
为什么要挑地方?因为未观测区是一片彩色涂抹,把它算进最小二乘,拟出来的仿射会去迁就那片噪声,反倒把本来对得上的观测区拉歪。
这不是理论推演。你的结果目录里同时存着两套口径的评测,而它们给出相反的结论。
仪器 2 · 同一次渲染,两种拟合口径
下面全是 results/preexpB/ 里的真实数字。点按钮切换口径——注意不带仿射的那三行逐位相同,说明这是同一次渲染、同一个 checkpoint。
差别有多大:观测区差 2.09 dB,未观测区差 3.95 dB,而且方向相反。如果拿其中一套当基线、另一套当实验组,你会得出「这个干预让未观测区暴跌 4 dB」的结论——纯属口径不一致造成的幻觉。
BM_s552_base2_*.json 和 BM_s552_dw0.01_*.json 记录的 ckpt 路径完全一样,四个步数上 psnr、psnr_obs、psnr_unobs、frac_obs 全部逐位相同,只有带 _aff 的三项不同。也就是同一次跑被用两版仿射代码各评了一遍。
其余所有实验(aniso*、fisher*、sparseadam、dw0.1、filled*)的观测区仿射 PSNR 都落在 21.2 到 21.7,跟 base2 是一套;只有 dw0.01_* 那六份是 19.1 左右的旧口径。做对比表时基线要用 base2,dw0.01_* 那六份要么重评要么剔除。
不分区会得出什么错误结论
现在把前面几节合起来。假设你老老实实报一个整图 PSNR,会发生什么?
PSNR 是从 MSE 来的,而 MSE 按面积加权。所以整图的 MSE 是两区的面积加权平均:
关键在于 MSE 是线性加权而 PSNR 是对数的,所以差的那一区会以远超其面积占比的力度把整图数值拽下去。拖一下就明白:
仪器 3 · 未观测区怎么绑架整图 PSNR
两个分区的 PSNR 固定成 s23 的真实值,只拖未观测区的面积占比。
这个模型不是近似——在 s23 上它精确复现了实测值(差 0.00 dB),因为那个场景每一帧的观测比例都是 11.0%。s552 上差 0.78 dB,因为它逐帧比例从 9.6% 到 100% 大幅波动,逐帧平均 PSNR 和整体加权不完全等价。
结论很直白:在 s23 那种 82% 未观测的设定下,整图 PSNR 基本就是未观测区的 PSNR,观测区做得再好也看不出来。你要是拿整图数字去比两个方法,比的其实是「谁把没信息的地方糊得更像」。
外推 benchmark 报的是整图指标,所有方法在上面都大幅下跌(你调研到的是 −25% 到 −31%)。但跌幅里有多少来自「表示确实退化」、多少来自「那片区域本来就没有信息」,它没有拆开。拆开这件事就是你现在手上这套协议在做的。
这一课能撑起什么
把这一课的东西按「能不能写进论文」排一下队,顺便标清楚每条还差什么:
| 结论 | 证据强度 | 还差什么 |
|---|---|---|
| 留出相机的画面里有 33% 到 82% 的像素从未被任何训练视角框进过 | 硬 | 把 §5.1 那个 15k 的异常格解释掉或重跑 |
| 不分区的整图 PSNR 由未观测区决定,测不出表示的性质 | 硬 | 可以直接写,模型和实测都对得上 |
| 留出视角评测必须后拟合仿射,且要在观测区上拟合 | 硬 | 有同一次渲染两种口径差 2 到 4 dB 的直接证据 |
| 训练越久外推越差 | 弱但真实 | 观测区 5k→30k 只掉 0.3 dB,同期训练视角涨 2 dB。效应小,要多场景才站得住 |
| 观测充分度与质量的关系 | 还没做 | 把 min_views 扫一遍就有,成本很低 |
| LiDAR 初始化的颜色泄漏已修正 | 还没做 | 第二课 §4.1 那个漏洞,未观测区的绝对数字要打折扣 |
前三条是可以直接支撑一篇分析/协议型文章的骨架。后三条是接下来最划算的三件事——尤其 min_views 扫描,改一个命令行参数就能跑。
❧
自查清单
- 说出常规 NVS 协议和留出相机协议各自在问什么问题。
- 说出判定一个像素「被观测过」的四个步骤。
- 说出这个协议的三个弱点,以及每个弱点让结论偏向哪一边。
- 解释为什么仿射要在观测区上拟合,不在整图上拟合。
- 说明为什么未观测区的面积占比会以超过其比例的力度影响整图 PSNR。
- 插值 vs 外推 interpolation / extrapolation
- 测试视角落在训练视角的包络之内还是之外。前者问重建保真度,后者问泛化。
- 留出相机 held-out camera
- 把某几条相机的全部帧移出训练集,只用作测试。制造空间外推最直接的办法。
- 观测区 / 未观测区 observed / unobserved
- 按「反投影出的三维点是否落进过任何训练视锥」划分的两类像素。
- 后拟合仿射 post-hoc affine fit
- 评测时对渲染结果拟合一个全局的 \(a\cdot I+b\) 再算指标,用来消除曝光差异这个混淆项。闭式最小二乘,无额外成本。
- 视锥测试 frustum test
- 判断一个三维点是否落在某相机的可视范围内。只看几何,不查遮挡。