街景 3DGS 补课 · 第五课 · 2026-09-03
重读你们自己的结果
从八月的共视率统计到 09-02 那晚的通宵实验,数字已经堆了一大摞。这一课把它们逐条摊开:怎么算出来的、能支撑什么结论、不能支撑什么。最后给出按可信度排序的清单,和三件最划算的后续。
这一课在做什么
科研里最贵的不是跑实验,是知道自己手上那堆数字到底能说明什么。这一课就干这一件事。
先把结论摆在最前面,后面各节是展开:
| 结论 | 可信度 | 一句话 |
|---|---|---|
| 八个示例场景里四个的车完全没动 | 硬 | 八月所有实验都在静止的车上做的 |
| 光度 Fisher 沿视线退化三到七个数量级 | 硬 | 最弱方向就是视线方向,估计器工作正常 |
| 行驶场景里高斯沿视线越训越长 | 硬 | 机制是横向被数据压薄,不是纵向被拉长 |
| 留出相机评测必须分区 | 硬 | 见第四课 |
| 六个训练侧干预都没用 | 硬(负结果) | 观测区在噪声里,未观测区一律更差 |
| kNN 填色让未观测区涨 1.95 dB | 强但单场景 | 零训练成本,方向指得很明确 |
| 训练越久外推越差 | 弱 | 只有 0.3 dB,撑不起单独的主张 |
| 「隐性 few-shot」这个叙事 | 要改写 | 共视率低的原因跟原来说的不是一回事 |
先修一个前提:车根本没在开
这是 09-02 晚上上机第一件事查出来的,也是整晚最重要的发现,因为它动摇的是八月全部实验的前提。
preexp/scan_motion.py 直接读原始 tfrecord,累加相邻帧之间 ego 位姿平移的长度:
P = [每帧的 frame.pose.transform 的平移部分]
step = ||diff(P)||           # 每一步走了多远
path = step.sum()            # 路径总长
disp = ||P[-1] - P[0]||      # 首尾直线位移
八个示例场景的结果:
仪器 1 · 八个示例场景的 ego 位移
2026-09-02 实测。橙色是「车在动」的,灰色是完全静止的。
八月的核心叙事是「前向行驶导致逐点共视率极低,所以驾驶场景本质是隐性 few-shot」。但在这四个静止场景上,车压根没往前开——低共视率不是行驶造成的,是360° 的 LiDAR 撒点对上三个只朝前的相机造成的。
所以「forward-moving rig」这个说法在这些场景上不成立。反过来说,静止场景是更极端的 few-shot:背景只被三个固定视点看过,深度方向完全没有视差。结论方向没错,但理由要换,而且要换到真正在开的场景上重做。
你已经筛了两段真正在开的(100 米和 196 米)并预处理好了。这是所有后续实验的前提——在停着的车上量出来的东西,不能拿去支撑关于行驶场景的主张。
共视率 12.7% 到底说明了什么
八月那张动机图:Waymo s23,150 帧 × 3 相机,6 万个 LiDAR 点,统计每个点被多少比例的视角看到。结果是均值 12.7%、中位数 0、64.4% 的点落在最低区间。
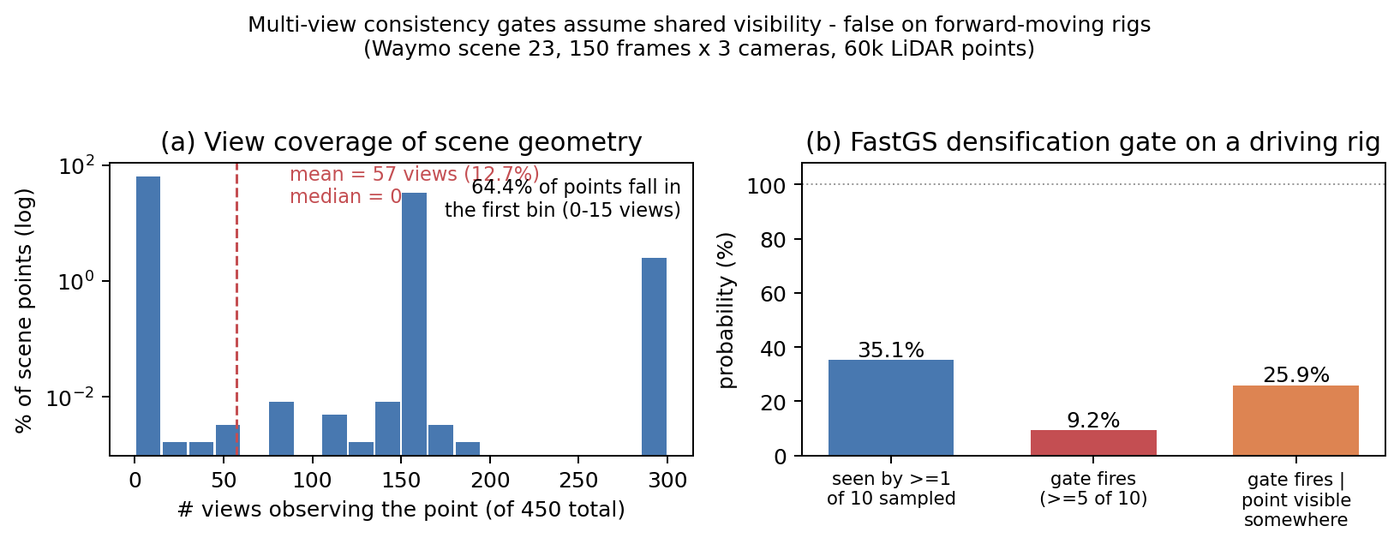
results/figs/covis_motivation.png)。数字本身没问题,需要改的是对它的解释。这个统计算得没错,但它现在支撑的结论要收窄。s23 正是那四个静止场景之一,所以:
- 能说的:场景里绝大多数点只被很少的视角看到,逐点观测极度不均衡。这一条成立,而且被第四课的分区结果独立佐证了(留出相机时 82% 的画面没人看过)。
- 不能说的:这是「前向行驶」造成的。s23 的车没动。真正的原因是 LiDAR 覆盖 360°、相机只覆盖前方一个扇区,大量点从一开始就在任何相机的视野之外。
- 要补的:在真正行驶的场景(新筛的那两段)上重做这张图,并且只统计落在相机视锥内的点,把「传感器视场不匹配」和「视角多样性不足」这两件事分开。
这不是白做。把一个统计量的解释修正掉,本身就是研究的一部分,而且修正之后的版本更难被审稿人打。原来那个说法有个明显的攻击面:「你怎么知道低共视是行驶造成的,而不是标定和视场造成的」。分开统计之后这个口子就补上了。
光度 Fisher 沿视线退化
这是整晚最硬的一条诊断,而且它跟第一课 §3 那个雅可比是同一件事的两种说法。
做法:用随机探针(K=8,450 / 420 个视角)估计每个背景高斯的相机 Fisher 位置块 \(F_i^{\mathrm{pos}}\in\mathbb R^{3\times3}\),看它的特征值。
| 量 | s23(静止) | s552(行驶 28 m) | 怎么读 |
|---|---|---|---|
| \(\lambda_{\min}/\lambda_{\max}\) | 4e−7 | 1.7e−3 ~ 5.6e−3 | 沿视线的光度约束比横向弱 3 到 7 个数量级。运动把它抬了四个数量级,但仍差千倍 |
| 最弱方向与视线的 \(|\cos|\) | 1.000 | 0.99 | 最弱方向就是视线方向——这同时说明估计器工作正常 |
| LiDAR 深度探针把最弱方向抬高的倍数 | ×2.6e4 | ×25 ~ ×140 | 深度补的确实是视线方向 |
| 默认权重下合成后的各向异性 | — | 1.7e−3 → 2.3e−3 | 补完之后沿视线仍比横向弱 400 倍 |
第二行是这张表里最值得强调的:最弱特征方向和视线方向的余弦是 0.99 到 1.000。这不是巧合,是第一课 §3 那个雅可比的直接后果——投影的雅可比在光轴附近对深度方向近乎零响应。解析上早该如此,数值上确认了。
最后两行合起来是个很干净的论证:LiDAR 深度确实是补这个方向的唯一信息源(把最弱特征值抬了 25 到 140 倍),但在默认权重下补完仍差 400 倍。这就是 v3 里 M2 的立足点,也是它到现在仍然没被证伪的部分——第二课 §5 那条注解说过,被证伪的是「统一权重 ×10」,不是「按方向加权」。
高斯沿视线越训越长,但机制跟猜的不一样
原来的猜法(沿用 VEGS)是「协方差的薄轴倒向相机」。实测把它推翻了:
| 量 | s23(静止) | s552(行驶) | 结论 |
|---|---|---|---|
| 沿视线厚度 / 横向厚度,15k → 30k | 0.98 → 0.88 | 1.19 → 1.24(低覆盖) 1.43 → 1.67(中) 1.26 → 1.56(高) | 行驶场景里越训越长;静止场景反而在变短 |
| 哪根轴倒向视线(\(|\cos|\)) | 中轴 0.78 薄轴只有 0.29 | 中轴 0.6–0.68 长轴 0.42–0.54 | 不是薄轴。薄轴对准视线那是「面对相机的盘」,不是躺平 |
| 15k→30k 位移落在最弱方向的能量占比 各向同性基准 = 0.33 | 0.11 | 0.24 – 0.27 | 位置漂移不集中在零空间 → H2 的位置版本不成立 |
| 15k→30k 形状变化的中位数 | 沿视线 0.32 横向 0.29 | 横向 −0.09 ~ −0.11 沿视线 −0.01 ~ −0.06 | 机制是横向被数据收紧、纵向没人管,比值因此变大 |
最后一行是关键。不是有什么力量把高斯沿视线拉长,而是横向被数据压薄了、纵向没有任何东西去压它,两个方向不同速地收缩,比值就上去了。这个说法比原来的「躺平」精确得多,而且直接跟 §3 的 Fisher 结果咬合:横向 Fisher 大所以收得动,纵向 Fisher 小所以收不动。
15k → 30k 的逐高斯比较是靠互为最近邻匹配做的(半径 0.1 米),匹配率只有 59% / 50%。因为 DriveStudio 的高斯没有持久 ID,密度控制一分裂就对不上了。
意思是这一节的所有「随训练变化」的数字,都只覆盖了一半的高斯,而且是幸存下来且没被分裂过的那一半——这是一个有偏样本。要正式写进论文,得给训练加持久 ID(第三课 §6 的改动索引里「存更多东西进 checkpoint」那条)。
六个训练侧干预,全是负结果
诊断做完,接下来就是照着诊断去干预。六个变体,同一套协议(s552 五相机、留出侧相机、分区评测),全部跑 15k 步。
下面这张表用的是不做仿射校正的原始 PSNR。原因见第四课 §6:仿射的拟合口径中途改过,只有原始值在所有变体之间严格可比。
仪器 2 · 六个干预 vs 基线
点任意一个变体看它在三个步数上的表现。横轴是相对基线的差值,右边好、左边差。
形状非常一致:观测区全部落在 −0.01 到 +0.12 dB,也就是基线自己步与步之间的波动范围内;未观测区一律变差,从 −0.19 到 −0.77 dB。没有一个变体在观测区做出了能跟噪声区分开的改善。
唯一值得单独说的是 Sparse Adam:它是三个步数上观测区都略正的那个(+0.12 / +0.20 / +0.12),而且高斯数还少了 14%(218 万 → 188 万)。这支持 AdamW-GS 那篇说的「不可见高斯的隐式更新有害」在驾驶场景也成立,但 0.1 到 0.2 dB 的效应量撑不起一篇方法论文。
各变体的训练视角 PSNR 都在 29.7 到 29.9 之间,外推观测区都在 18.2 到 18.5 之间。训练拟合上 0.2 dB 的差异,完全说明不了外推的问题。换句话说,外推的天花板不在优化器上——这本身就是个值得写的观察。
为什么全都不管用
六个变体全军覆没,但它们失败的方式高度一致——凡是约束几何的干预,未观测区都变差。这个共同点比任何单个负结果都有价值,因为它指向一个机制。
机制是这样的:未观测区的渲染,本来就是边界上那些被拉长的高斯「糊」进去的一片。糊得越平滑、越接近周围的平均色,跟真值的均方误差反而越小。而 PSNR 是均方误差的对数——
所以你去约束形状、不让它拉长,等于把糊的能力撤掉,露出来的是 LiDAR 初始化留下的杂色高斯或者空洞——PSNR 当然掉。
这不是说干预错了,是说 PSNR 在未观测区衡量的根本不是你想衡量的东西。它奖励平滑的幻觉。这一条如果写清楚,本身就是对整个外推评测领域的一个提醒。
Fisher 阻尼这条路,小c的看法是要么换做法、要么放弃。理由有两条:一是阻尼越强伤得越重(τ=0.01 时未观测 −0.32,τ=0.1 时 −0.66),呈现出剂量反应关系,不像噪声;二是单视角两根探针给出的是秩 2 的估计,太粗——被压住的「弱方向」里可能有一部分其实是别的视角能钉住的,只是这次探针没采到,冻住它们反而让几何调不对。
要救的话,方向是把 Fisher 累积得更久(跨多个视角、多步),而不是调 τ。
唯一有大效应的那个:给没被看过的高斯借个颜色
做法零成本,也不需要重新训练:把从来没被任何训练相机看过的高斯,颜色换成最近 8 个「被看过」高斯的均值,高阶球谐清零。
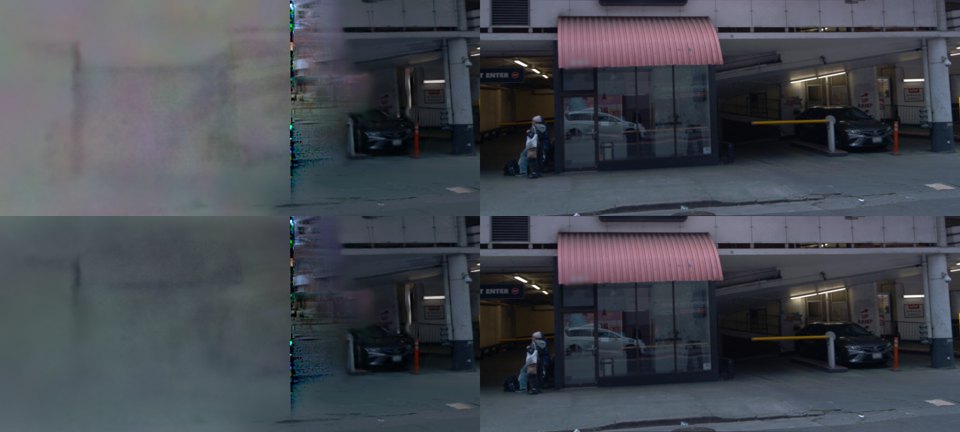
| 处理 | 未观测区 | 整图 | 观测区 | 读法 |
|---|---|---|---|---|
| s552 基线 | 14.26 | 16.16 | 18.16 | 保持初始化时投影得到的颜色 |
| s552 + kNN 填色 | 16.21 (+1.95) | 17.09 (+0.93) | 18.16 | 观测区分毫未动,说明改动干净 |
| s552 + 灰色填色 | 13.78 | 15.92 | 18.16 | 比什么都不做还差 |
| s552 + 直接透明 | 13.02 | 15.91 | 16.44 | 观测区掉了 1.7——这些高斯连观测区也在参与渲染 |
| s23 基线 | 16.33 | 14.82 | 24.93 | |
| s23 + kNN 填色 | 17.37 (+1.04) | 15.11 | 24.93 | 两个场景方向一致 |
| s23 + 灰色填色 | 14.98 | 14.04 | 24.93 |
排序很说明问题:kNN 填色 > 保持初始化颜色 > 直接透明 > 灰色。
两个推论:
- 那些高斯不是死的。「直接透明」把观测区也拖低了 1.7 dB,说明从没被看过的高斯同时也在给观测区的像素做贡献。不能简单删掉。
- 问题的性质是「外观没有信息来源」,跟训练动力学无关。零训练成本的一个颜色替换就拿到 +1.95 dB,而六个训练侧干预加起来都是负的。这两件事放在一起,方向指得非常明确。
kNN 填色只是最粗的版本,而且它涨的那 1.95 dB 里,有多少只是「糊得更像周围」,跟 §6 讲的是同一个机制?这个问题现在没法回答,因为唯一的指标还是 PSNR。要把它变成一个真正的贡献,得先有一个不奖励平滑的评价方式,或者换成有生成先验的方法再比。
每条结论能撑什么,以及接下来最划算的三件事
把 §0 那张表展开成带「还差什么」的版本:
| 结论 | 能不能直接写 | 还差什么 |
|---|---|---|
| 四个示例场景的车完全没动,八月实验的前提要修 | 能 | 换到真正行驶的场景重做关键实验 |
| 光度 Fisher 沿视线退化,最弱方向就是视线 | 能 | 多场景重复一遍,现在只有两个 |
| LiDAR 是唯一补这个方向的信息源,但默认权重下仍差 400 倍 | 能 | 这是 M2 还活着的理由 |
| 行驶场景里高斯沿视线越训越长,机制是横向被压薄 | 基本能 | 匹配率只有五成且样本有偏,要给高斯加持久 ID |
| 六个训练侧干预都是负结果 | 能 | 负结果本身就是贡献,但要说清失败机制(§6) |
| PSNR 在未观测区奖励平滑的幻觉 | 能,而且这条最有价值 | 最好补一个不奖励平滑的指标做佐证 |
| kNN 填色 +1.95 dB | 作为观察能写 | 单场景、单指标,且没排除「糊得更像」的解释 |
| 训练越久外推越差 | 不建议单独写 | 只有 0.3 dB,需要多场景多种子 |
最划算的三件事
- 修 LiDAR 上色的留出泄漏,重跑基线。第二课 §4.1 那个漏洞。改动很小,但它决定了未观测区所有绝对数字的可信度——不修的话上面每一个数字都要打折扣。
- 把
min_views扫一遍。第四课 §5.3。改一个命令行参数,就能得到「观测充分度 vs 质量」的曲线,直接把 §2 那个共视率统计和 §5 的评测结果连起来。 - 在新筛的两段行驶场景上重做 §3 和 §4。这是把「静止场景」这个前提问题真正解决掉的唯一办法,也是让前面所有诊断从两个场景变成四个场景的最快路径。
三件事都不需要新想法,只需要机时。服务器一开就能排队。
❧
自查清单
- 说出为什么「四个场景的车没动」会动摇八月的核心叙事,以及叙事该怎么改。
- 说出 Fisher 最弱方向与视线夹角的实测结果,以及它跟第一课那个雅可比的关系。
- 说出「越训越长」的真实机制,以及它跟原来的猜法差在哪。
- 说出六个干预的共同失败模式,以及背后的机制。
- 说出为什么「直接透明」会把观测区也拖低。
- 说出接下来最划算的三件事,以及各自解决什么问题。
- Fisher 信息块 per-Gaussian Fisher block
- \(F_i=\sum_v J_{i,v}^\top J_{i,v}\),衡量训练图像把这个高斯的哪些参数方向钉住了。特征值大=钉得死,接近零=数据对它沉默。
- 随机探针 Rademacher probe
- 不改 CUDA、只用反向传播估计 Fisher 的办法:用随机向量去探测雅可比,K 次探针给出一个秩 K 的估计。这里 K=8。
- 互为最近邻匹配 mutual nearest-neighbour matching
- 因为高斯没有持久 ID,跨 checkpoint 比较只能靠位置就近配对,且要求双向都是最近邻。匹配率五成左右。
- 剂量反应 dose–response
- 干预强度越大、效应越大的规律。观察到它通常说明效应是真的,不是噪声——即使效应方向是坏的。